وش هو ملف .tbi اللي جا مع ملف الجينوم الكامل .vcf.gz، وهل أحتاجه عشان أحلل الـ DNA حقي؟
ملف .tbi فهرس tabix لملف .vcf.gz، ما تحتاجه لقراءة الملف كامل، وأداة الـ DNA المجانية تبي .vcf.gz بس. هنا متى يفرق الفهرس ووش تسوي بباقي الملفات.
ملف .vcf.gz.tbi هو فهرس tabix، يعني جدول بحث صغير لملف VCF الجينوم الكامل المضغوط على شكل بلوكات. ما تحتاجه عشان تقرأ الملف كامل من أوله لآخره، وفي أداة HealthOSX المجانية للـ DNA ترفع ملف .vcf.gz بروحه. الفهرس يفرق بس لما يبي برنامج يروح مباشرة لجين معيّن أو منطقة معيّنة في كروموسوم.
وش هو ملف .vcf.gz.tbi اللي جا مع ملف VCF الجينوم الكامل
هو فهرس tabix. الشركة اللي سوّت لك التسلسل (Nebula أو Dante Labs أو Sequencing.com أو أي جهة شغّلت الـ pipeline) غالباً جداً ضغطت ملف VCF بـ bgzip وبعدين شغّلت عليه tabix، مع إن الخطوات بالضبط تعتمد على الـ pipeline حقهم. النتيجة ملف ثاني بنفس الاسم وزايد عليه .tbi. يعني sample.vcf.gz هو بياناتك، وsample.vcf.gz.tbi هو فهرس المحتويات حقه.
الفهرس ما فيه أي معلومة جينية عنك. حجمه عادة من كيلوبايتات إلى كم ميغابايت، بينما ملف VCF ممكن يوصل لمئات الميغابايتات أو كذا غيغابايت. لو حذفته ما تخسر أي معلومة جينية، لأنه ينبني من جديد من ملف VCF، بس بشرط يكون ملف .vcf.gz مضغوط بصيغة BGZF ومرتّب حسب الموقع. الشرطين مشروحين في القسم الجاي.
ليش ملف VCF المضغوط يحتاج فهرس أصلاً
ملف VCF للجينوم الكامل فيه كذا مليون متغيّر مرصود (variant call)، مرتّبة حسب الكروموسوم والموقع. ضغط gzip العادي عبارة عن تدفّق واحد متصل، فعشان توصل لكروموسوم 17 لازم تفك ضغط كل اللي قبله.
صيغة BGZF (اللي يكتبها bgzip) تحل هالمشكلة لأنها تضغط على شكل بلوكات صغيرة كثيرة مستقلة عن بعض، كل بلوك فيه تقريباً 64 KB من النص قبل الضغط (bgzip يكتب بلوكات أقل بشوي من 64 KiB). ويظل ملف .gz صالح، وعشان كذا gunzip العادي يفتحه. بعدين فهرس tabix يسجّل لكل جزء من الجينوم موقع البلوك داخل الملف (file offset) اللي تبدأ منه هذي السطور. لو طلبت chr7:117,000,000-117,400,000 البرنامج يقرأ الفهرس، ويقفز للبلوك الصح، ويفك ضغط كم بلوك ويوقف.
وهذا يعني شرطين. لازم يكون ملف VCF مرتّب حسب الموقع، ولازم يكون BGZF مو gzip عادي. tabix بيرفض ملف gzip العادي ويقول لك إنه ما انضغط بـ bgzip. لو واحد من الشرطين ناقص، ما تقدر تبني الفهرس من جديد لين تصلّح الملف (شوف قسم إعادة البناء تحت).
أي ملف أعطيه لأداة الـ DNA
أعطها ملف .vcf.gz بس. الأداة تقرأ الملف في متصفحك من أول سطر لآخر سطر، فما تحتاج تتنقّل فيه أبداً، والفهرس ما يضيف شي. لو مو متأكد إن ملفك بيشتغل، افحصه أول في أداة فحص ملفات DNA.
| الملف | وش هو | ترفعه؟ |
|---|---|---|
| sample.vcf.gz | المتغيّرات المرصودة حقك، مضغوطة بصيغة BGZF | إيه |
| sample.vcf | نفس المتغيّرات، بدون ضغط | إيه |
| sample.g.vcf.gz | gVCF: المتغيّرات مع المقاطع اللي تطابق المرجع | مو الملف اللي تبدأ فيه |
| sample.vcf.gz.tbi | فهرس tabix لملف .vcf.gz | ما تحتاجه |
| sample.vcf.gz.csi | صيغة فهرس بديلة | ما تحتاجه |
| sample.bam / sample.cram | قراءات تسلسل مصفوفة على المرجع، مو متغيّرات مرصودة | لا، هذي قراءات |
Scroll the table sideways for the rest →
وش كل ملف، وهل ترفعه لأداة الـ DNA المجانية.
ملاحظة وحدة على الملف نفسه. لو عمود ID في ملف VCF حقك كله نقطة (مخرجات GATK أو Sentieon الخام)، فما فيه rsIDs نطابق عليها. الأصول الجينية للملفات اللي ما فيها rsIDs تنطابق على إحداثيات GRCh37، فلو ملفك GRCh38 افحصه في أداة فحص ملفات DNA بدل ما تفترض إنه بيشتغل.
متى تحتاج الفهرس فعلاً
أي شي يطلب منطقة معيّنة يحتاجه. الأداة اللي تقرأ الملف كامل ما تحتاجه.
| المهمة | تحتاج فهرس |
|---|---|
| قراءة الملف كامل من أوله لآخره (أداة في المتصفح، أو bcftools view للملف كله) | لا |
| bcftools view -r (منطقة وحدة) | إيه |
| bcftools view -t (targets، يمر على الملف كامل) | لا |
| فتح ملف VCF كمسار (track) في IGV | للملفات الكبيرة، إيه |
الفهرس بس للقفز لمنطقة معيّنة.
bcftools view -r chr7:117000000-117400000 sample.vcf.gzيحتاج فهرس، ويوقف بخطأ لو ما فيه فهرس. ما يرجع للمسح من نفسه. بدون فهرس،bcftools view -t chr7:117000000-117400000 sample.vcf.gz(targets) يشتغل، لأنه يمر على الملف كامل ويفلتر وهو ماشي. أبطأ، بس يجيب لك المنطقة.- IGV يحتاج ملف .tbi أو .csi مطابق عشان يحمّل ملف VCF كبير مضغوط بـ bgzip منطقة منطقة. ملف VCF الصغير ينفتح بدون فهرس، لأن IGV يقرأه كامل في الذاكرة.
- البحث عن جين واحد في جينومات كثيرة، أو عن متغيّر واحد في ملف مجموعة كبيرة (cohort)، هذا بالضبط اللي انبنى الفهرس عشانه.
الغلطة الشائعة إنك تغيّر اسم sample.vcf.gz وتخلي ملف .tbi على اسمه القديم. البرامج عادة تدوّر على الفهرس بإضافة .tbi على اسم ملف البيانات بالضبط، فلازم الاثنين يمشون مع بعض.
وإذا التحميل فيه كمان .g.vcf.gz، أو ملفات SNP وindel منفصلة، أو BAM أو CRAM
ملفات التسلسل غالباً تجي بكذا ملف، وبعضها بس هو اللي فيه المتغيّرات المرصودة.
- ملف VCF للمتغيّرات هو اللي ترفعه. هذا ملف
.vcf.gzحق المتغيّرات المرصودة، وغالباً اسمه شي مثلsample.vcf.gzأوsample.snp.vcf.gz. .g.vcf.gz(gVCF): نوع ثاني من VCF يسجّل كمان المقاطع اللي تطابق فيها المرجع. أكبر حجماً ومصمّم للتحليل المشترك (joint analysis)، فهو مو الملف اللي تبدأ فيه. استخدم ملف.vcf.gzالعادي للمتغيّرات بداله.- ملفات VCF منفصلة لـ SNP وindel: لو فيه كمان ملف
.vcf.gzمدموج، استخدمه. بعض النتائج المسمّاة عبارة عن indels (APOL1 G2 حذف بطول 6-bp)، فالملف اللي فيه SNP بس ممكن تفوته. لو ما فيه إلا الملفات المنفصلة، افحص الاثنين في أداة فحص ملفات DNA قبل ما تعتمد على أي واحد منهم. .bamأو.cramمع.baiأو.crai: هذي قراءات تسلسل مصفوفة على المرجع (aligned reads)، مو متغيّرات مرصودة، و.baiو.craiهي الفهارس حقها. مو هي الملفات اللي ترفعها.
أداة الـ DNA موثّقة لملفات .vcf و.vcf.gz. لأي شي ثاني، ومنها gVCF وBAM وCRAM، استخدم أداة الفحص بدل ما تفترض إنه بيشتغل.
ناقص أو قديم أو ما يطابق: كيف تبنيه من جديد
الفهرس يخزّن مواقع بالبايت داخل ملف واحد محدّد. لو فكّيت ضغط ملف VCF وضغطته مرة ثانية، أو عدّلته، أو حطيت مكانه ملف من تشغيل ثاني، هالمواقع بتأشّر على أماكن غلط. حسب البرنامج، يطلع لك خطأ، أو تحذير إن الفهرس أقدم من البيانات، أو الأسوأ وهو سجلات ناقصة أو غلط في استعلام المنطقة. الفهرس المبني لملف ثاني مو بقايا ما تضر. احذفه وسوّ واحد جديد.
- ابنه من جديد:
tabix -p vcf sample.vcf.gz، أوbcftools index -t sample.vcf.gz. أضف-fعشان يكتب فوق الفهرس الموجود. - gzip عادي بدل BGZF:
gunzip -c in.vcf.gz | bgzip -c > sample.vcf.gz، وبعدين سوّ له فهرس. - ملف غير مرتّب:
bcftools sort -O z -o sorted.vcf.gz in.vcf.gz، وبعدين فهرسه.
بعد أي إعادة ضغط، سوّ الفهرس من جديد. ياخذ من ثواني إلى كم دقيقة على جينوم كامل.
أقدر أحذفه؟ ووش قصة .csi
إيه، احذفه لو كل اللي تبيه ترفع ملف VCF أو تأرشفه، وخلّه لو ناوي تستخدم bcftools أو IGV على مناطق في ملفات كبيرة. ممكن كمان يمر عليك ملف .csi. يسوي نفس الشغل وbcftools index يسويه افتراضياً، بس يتعامل مع الكروموسومات الطويلة جداً اللي صيغة .tbi الأقدم ما تقدر عليها. كروموسومات الإنسان تدخل ضمن حدود .tbi، فبالنسبة لجينوم إنسان الاختيار نادراً يفرق، مع إن بعض البرامج القديمة ما تقرأ إلا واحد من الاثنين.
ملف .tbi هو فهرس محتويات لملف .vcf.gz حقك: تجاهله لو بتقرأ الملف كامل، وخلّه لو بتستعلم عن مناطق، وابنه من جديد كل ما تغيّر ملف .vcf.gz.
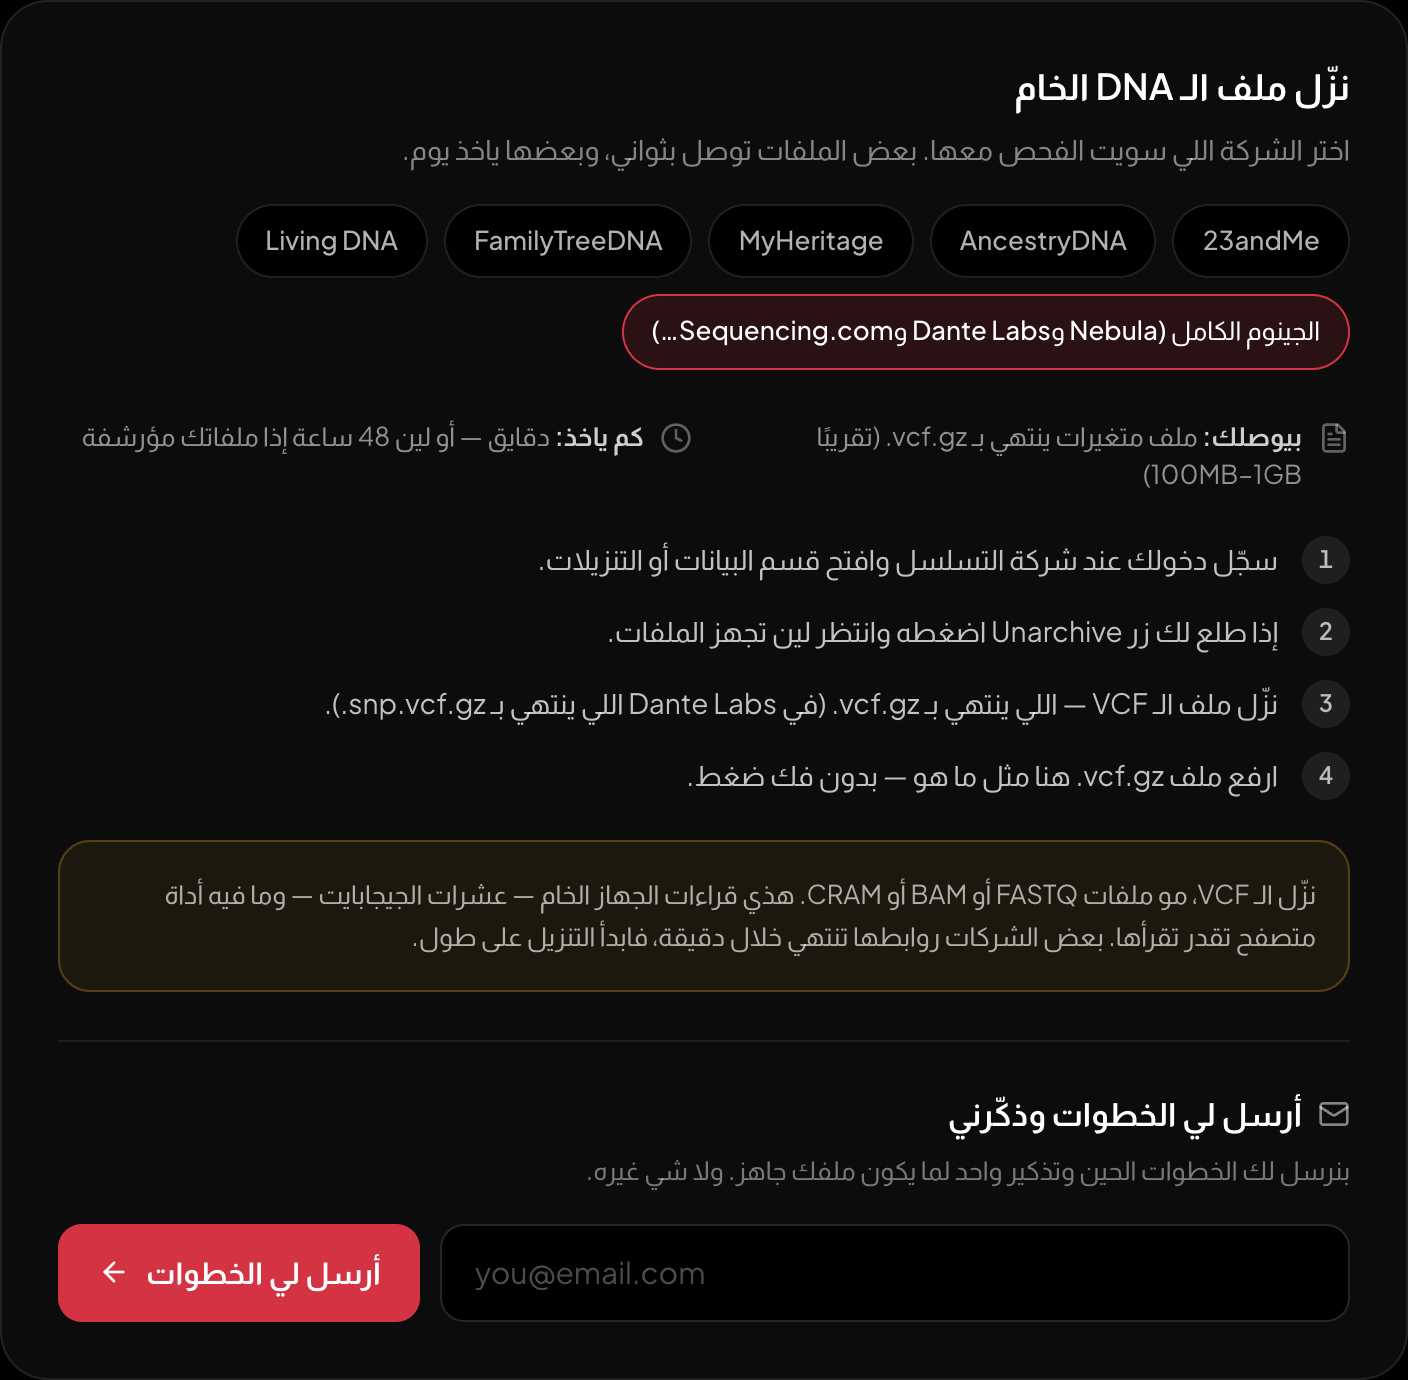
خطوات تنزيل ملف الجينوم الكامل داخل الصفحة نفسها.
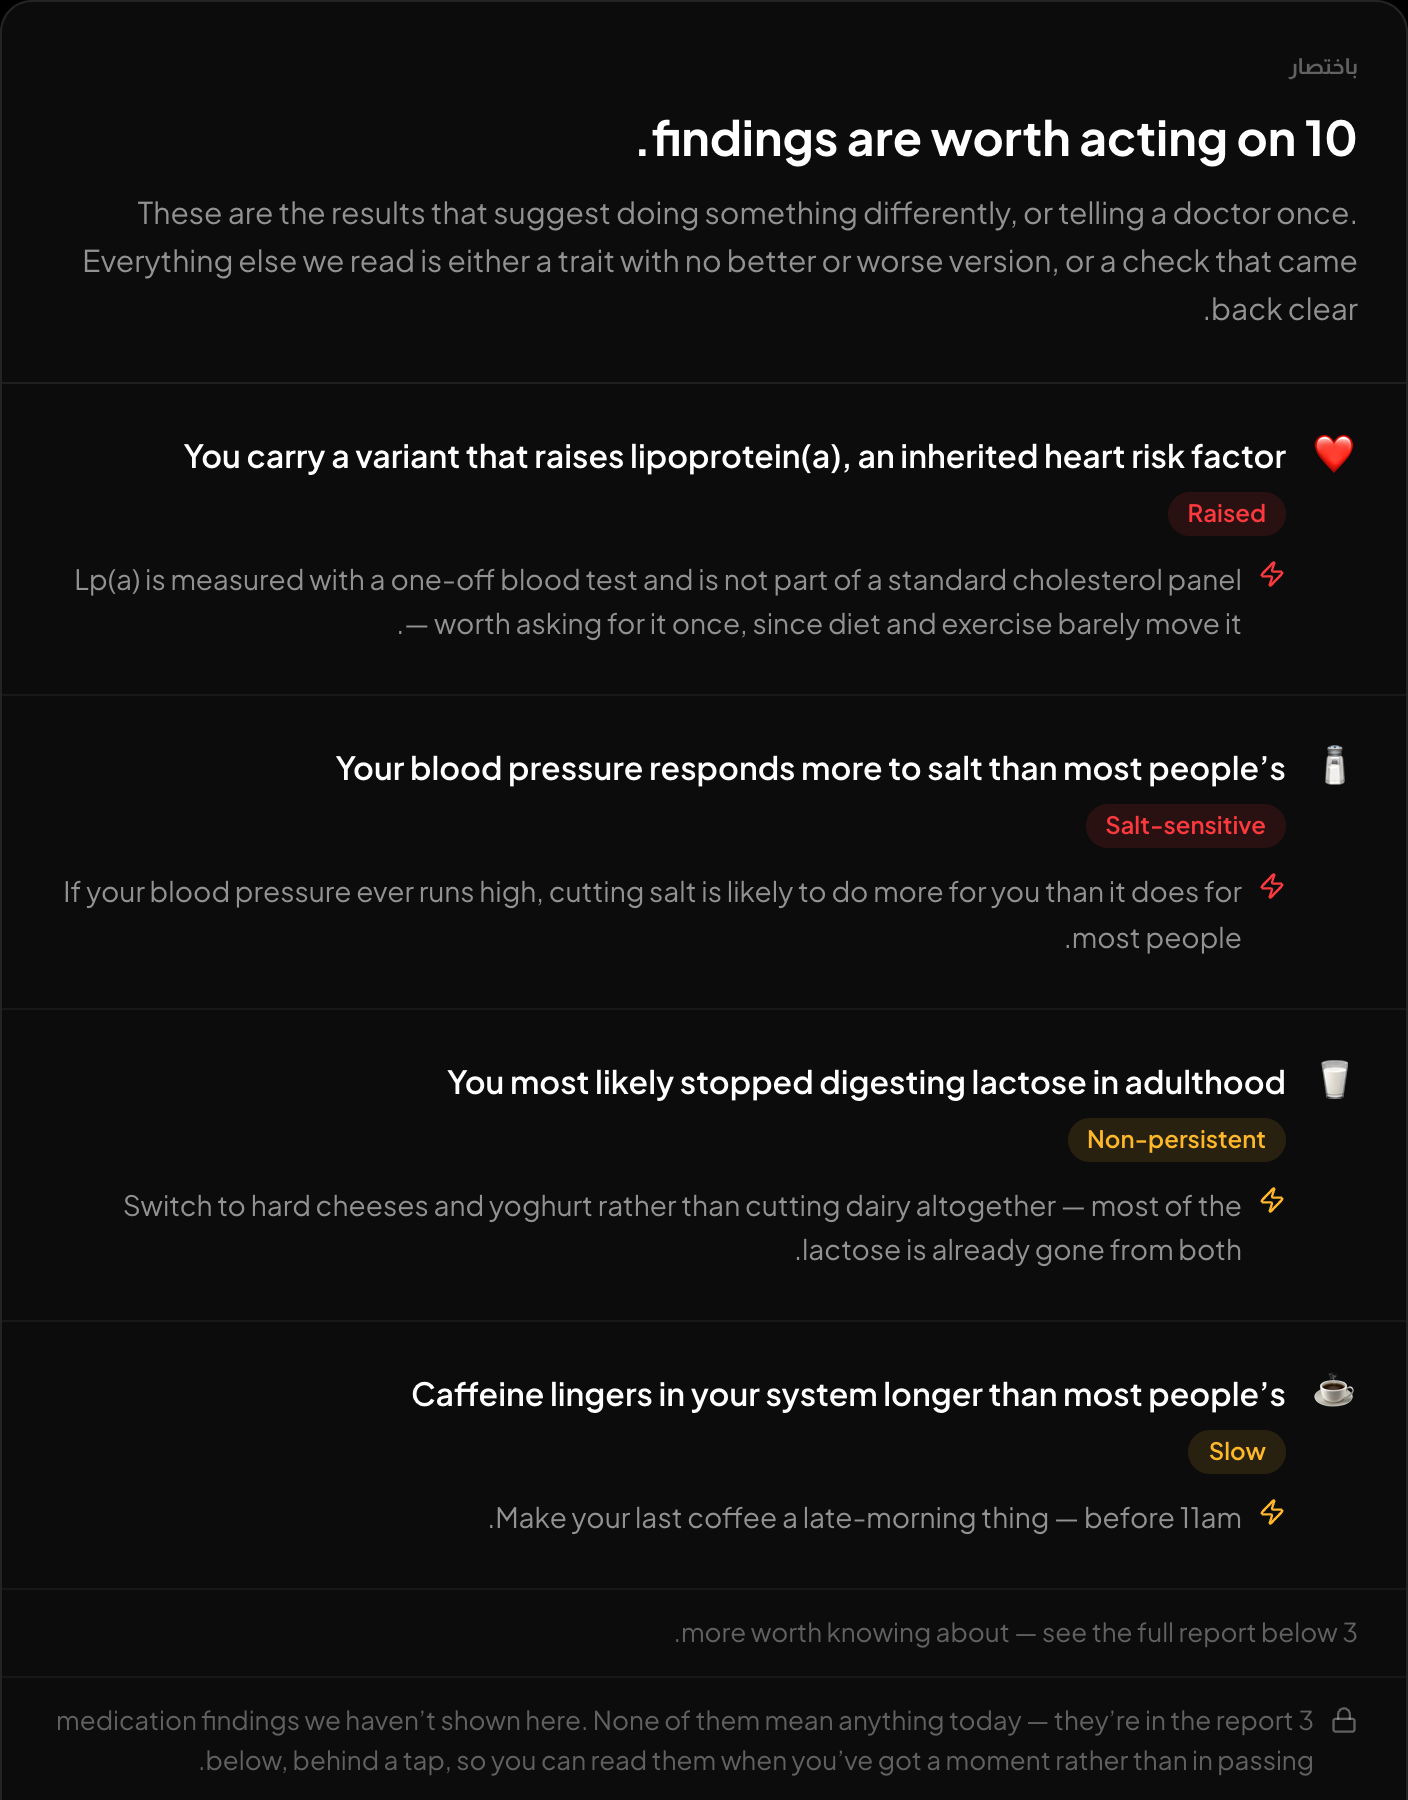
باختصار: وش يستاهل تسوي له شي.
لو تبي تشوف وش في ملف VCF حقك، أداة HealthOSX المجانية للـ DNA تقرأ ملف .vcf.gz في متصفحك. ملفات VCF للجينوم الكامل كمان تنفحص في المتصفح مقابل لوحات ClinVar، مع الصفات والاستجابة للأدوية والنتائج المتعلقة بحمل الجينات. الأصول الجينية اختيارية: لو اخترتها، بس العلامات الجينية اللي تحتاجها تنرسل للسيرفر، وبس بموافقتك. النتائج معلومات، مو تشخيص يطمّنك إن كل شي سليم، فالفحص النظيف ما ينفي أي شي.
جديد على ملفات DNA الخام؟ ابدأ بالدليل الكامل: كيف تحلل ملف 23andMe الخام مجانًا
كتابة
فريق أبحاث HealthOSX