هل أقدر أحوّل ملف 23andMe أو AncestryDNA الخام لجينوم كامل بالـ imputation؟ وهل يغني عن التسلسل الجيني؟
الـ imputation يوسّع ملف 23andMe أو AncestryDNA لعشرات الملايين من المواقع الإضافية، لكنها توقعات: الشائع منها يصمد، والنادر غالبًا لا.
نعم، تقدر تسوي imputation (استكمال جيني بالتوقع) لملف 23andMe أو AncestryDNA الخام وتوصله لعشرات الملايين من المواقع الجينية الإضافية، باستخدام سيرفرات مجانية مثل Michigan Imputation Server أو TOPMed Imputation Server. لكن الناتج توقع إحصائي وليس قياسًا، فهو ما يوصل لمستوى التسلسل الجيني (sequencing): يصمد مع المتغيرات الشائعة، ويفشل مع كثير من المتغيرات النادرة اللي تسبب الأمراض الوراثية.
نعم، لعشرات الملايين من المواقع المعروفة، مو لـ 3 مليار حرف
التحفظ كله على كلمة «جينوم كامل». الجينوم حوالي 3 مليار حرف، وأي شخص يختلف عن الجينوم المرجعي في حوالي 4 إلى 5 مليون منها تقريبًا. ملفك فيه تقريبًا 600,000 إلى 700,000 موقع قرأتها الشريحة (chip) فعلًا، وهي قائمة صغيرة وثابتة انختارت لأن هالمواقع تعطي معلومات مفيدة، مو لأنها المواقع المهمة لك أنت. الـ imputation يتوقع تركيبك الجيني (genotype) في مواقع أكثر بكثير، لكن فقط في مواقع المتغيرات الموجودة في لوحة مرجعية (reference panel). هذي أماكن معروفة يختلف فيها الناس عن بعض. أغلب الـ 3 مليار موقع متطابقة عند الكل، فما يتم تخمينها أصلًا. وأي شي برا اللوحة ما يتوقعه أبدًا.
عمليًا، الناتج يعتمد على اللوحة. بعد الفلترة توقّع عشرات الملايين من المواقع. لوحة HRC فيها حوالي 39 مليون موقع. لوحة TOPMed فيها مئات الملايين من المواقع قبل الفلترة، ولوحة 1000 Genomes بينهم.
كيف يشتغل الـ imputation، وليش درجات الجودة مهمة
الطريقة تعتمد على طريقة وراثة الـ DNA. المتغيرات القريبة من بعض تميل تنتقل مع بعض في كتل طويلة اسمها haplotypes، فإذا كنت حامل نسخة معينة في موقع قريب، غالبًا تكون حامل النسخة المطابقة لها في الموقع اللي بعده. اللوحة المرجعية مجموعة ناس انعمل لهم تسلسل كامل، فالـ haplotypes حقتهم معروفة بالكامل. البرنامج يمشي على كروموسوماتك ويطابق كل مقطع من نتائج الشريحة عندك مع مقاطع في اللوحة. إذا مقطعك يشبه haplotypes في اللوحة كلها تحمل T في موقع ما انفحص، يستنتج إنك على الأغلب تحمل T هناك بعد.
عشان كذا كل genotype متوقع يجي معه مستوى ثقة. يوصلك كاحتمال أو dosage، شي مثل 0.93 بدل 0 أو 1 أو 2 الواضحة، ومعه درجة جودة لكل متغير اسمها R2 أو INFO. المتغيرات الشائعة درجتها قريبة من 1. النادرة درجتها منخفضة، لأن اللوحة فيها أمثلة قليلة ينسخ منها. الفلترة على R2 هي اللي تفرّق بين التوقعات اللي تقدر تعتمد عليها والضجيج، وعشان كذا الخطوة 6 تحت مهمة.
الطريقة خطوة بخطوة
- 1.حوّل الملف. خذ ملف .txt الخام من 23andMe أو AncestryDNA وحوّله لـ VCF على نسخة GRCh37، وهي النسخة اللي تستخدمها الشركتين. الثنتين أصلًا تعطي النتائج على الـ plus strand. تحتاج ملف FASTA المرجعي عشان تحدد أليلات REF و ALT، فاستخدم ملف GRCh37 المطابق:
bcftools convert --tsv2vcf raw.txt -f human_g1k_v37.fasta -s mysample -Oz -o mysample.vcf.gz - 2.سوِّ فحص الجودة (QC). شيل المواقع اللي ما لها قراءة، واحذف الـ indels ومواقع الميتوكوندريا والـ Y، وتأكد من تطابق الـ strand والأليلات مع المرجع، وشيل المكرر. بعدها رتّب الـ VCF واضغطه بـ bgzip وسوِّ له index، وقسّمه حسب الكروموسوم إذا طلب السيرفر.
- 3.اختر السيرفر واللوحة. Michigan Imputation Server يوفر لوحة HRC (حوالي 32,000 شخص) ولوحة 1000 Genomes. TOPMed Imputation Server يستخدم لوحة TOPMed الأكبر بكثير (أكثر من 100,000 جينوم). الاثنين يحتاجون تسجيل مجاني، وسيرفر TOPMed ولوحات Michigan تطلب منك توافق على شروط الاستخدام البحثي، فاقرأها قبل ما ترفع. TOPMed ينقل بياناتك لـ GRCh38، فالنتائج ترجع لك على هالنسخة.
- 4.ارفع وشغّل. ارفع الـ VCF، واختر اللوحة والمجموعة السكانية لفحص الجودة، وانتظر. المهمة ممكن تاخذ من دقائق لساعات طويلة حسب الطابور.
- 5.نزّل النتائج. توصلك كملفات مضغوطة مشفرة، وكلمة السر تجيك بإيميل منفصل.
- 6.فلتر حسب R2. خلّ المتغيرات اللي فوق حد معين، عادة 0.3 للاستخدام العام، وأعلى مثل 0.8 إذا تهمك كل نتيجة لحالها، وراجع الطرف النادر بنفسك.
ملاحظة خصوصية: Michigan و TOPMed سيرفرات طرف ثالث. أنت ترفع بياناتك الجينية عندهم، والسيرفرات تحتفظ بالملفات فترة محدودة، حوالي 7 أيام، وبعدين تحذفها.
المتغيرات الشائعة تتوقع زين، والنادرة لا
المتغير الشائع يظهر على haplotypes كثيرة في اللوحة. البرنامج عنده أمثلة كثيرة يطابق عليها، ومواقع الشريحة المجاورة تدل عليه بوضوح.
المتغير النادر يحمله كم شخص في اللوحة، أو ولا أحد. المواقع المجاورة ما تقول عنه شي يُذكر، فالبرنامج ما عنده شي موثوق ينسخه. والطفرة اللي ظهرت في عائلتك أنت ما يمكن توقعها أبدًا، لأن ولا haplotype مرجعي احتواها من قبل.
النتيجة الموثّقة من ورقة TOPMed (Taliun et al., Nature 2021). قارنت دقة الـ imputation حسب فئات تكرار الأليل في عينات أوروبية، باستخدام لوحة TOPMed مقابل HRC و 1000 Genomes. أفضلية TOPMed على اللوحات الأقدم كانت أكبر في الفئات الأندر، لأن اللوحة الأكبر توفر haplotypes مطابقة أكثر. أما ورقة سيرفر Michigan (Das et al., Nature Genetics 2016) فتوصف السيرفر وطريقة Minimac، مو نطاقات دقة حسب اللوحة.
الحدود اللي تحت قواعد تقريبية متعارف عليها، مو أرقام من أي من الورقتين. قيمة r2 للـ imputation عادة فوق 0.9 للمتغيرات اللي تكرار أليلها فوق 5 بالمية. تنزل بشكل مستمر بين حوالي 1 بالمية و 0.1 بالمية، وتكون ضعيفة تحت حوالي 0.1 بالمية. حجم اللوحة يحرّك هالحدود:
- 1000 Genomes (2,504 شخص): الأصغر بين الثلاث، فالدقة تطيح أبكر كل ما صارت المتغيرات أندر.
- HRC (حوالي 32,000 شخص): أفضل بوضوح للمتغيرات قليلة التكرار، لكن أغلبها أوروبية.
- TOPMed (حوالي 97,000 جينوم في r2 إلى حوالي 133,000 في r3، وأكثر تنوعًا): الأكبر، وتحافظ على دقة قابلة للاستخدام لتكرارات أقل من الباقين.
حتى أفضل لوحة ما تنقذ المتغيرات النادرة جدًا. الملف النهائي يبان كامل، بينما طرفه النادر ضعيف أو مجرد ضجيج.
فيه مشكلة ثانية في الجهة المقاسة نفسها. Weedon et al., BMJ 2021 قارنوا نتائج الشرائح (arrays) مع التسلسل. البيانات الأساسية كانت شرائح Axiom من UK Biobank، وملفات 23andMe الاستهلاكية كتحقق ثاني. للمتغيرات الأندر من 1 في 100,000 في UK Biobank، فقط حوالي 16 بالمية من نتائج الشرائح تأكدت بالتسلسل، يعني أغلبها كانت إيجابيات كاذبة. فأي نتيجة نادرة مخيفة من ملف خام لازم تروح لمختبر سريري قبل ما أحد يتصرف بناءً عليها.
ملايين الأسطر مو ملايين القياسات.
الدقة تنزل إذا أصولك ما لها تمثيل كافي
الـ imputation يشتغل فقط إذا الـ haplotypes حقتك، أو أقارب قريبين لها، موجودة في اللوحة. لوحة 1000 Genomes ما فيها ولا مجموعة سكانية من الشرق الأوسط أو شمال أفريقيا أبدًا، و HRC أغلبها أوروبية. والشرائح بعد انصممت بشكل كبير حول التنوع الشائع عند الأوروبيين، فدلالتها أضعف عند غيرهم.
للقارئ من بلاد الشام أو الجزيرة العربية أو إيران أو شمال أفريقيا، هذا معناه إن فيه مقاطع من جينومك ممكن ما يكون لها تطابق قريب. البرنامج وقتها يستعير أقرب قريب غلط، والأخطاء تزيد، وأول الضحايا المتغيرات الشائعة في منطقتك لكنها نادرة في اللوحة. كم يسوء الوضع بالضبط يعتمد على اللوحة والشخص، وهذا للحين قاعد ينقاس.
اللي ما يقدر الـ imputation يوصله أبدًا
- الحذف والتكرار الكبير وغيرها من التغيرات الهيكلية
- تمدد التكرارات (repeat expansions)، يعني مقطع من الـ DNA يتكرر مرات أكثر من اللازم
- الطفرات الجديدة، وأي شي خاص فيك أو بعائلتك
التسلسل بالقراءات القصيرة (short-read) بعمق 30x يلتقط أغلب تغيرات الحرف الواحد والإدخالات والحذوفات الصغيرة، ومنها النادرة. لكنه للحين يفوّت بعض المناطق الصعبة في الـ mapping، وكثير من المتغيرات الهيكلية، وبعض تمدد التكرارات. والشريحة مع اللوحة تبدأ من موقف أضعف بكثير في كل هذي.
| المواقع | المتغيرات الشائعة | المتغيرات النادرة | المتغيرات الهيكلية وتمدد التكرارات | |
|---|---|---|---|---|
| ملف الشريحة الخام | حوالي 600,000 إلى 700,000، مقاسة | فقط إذا كانت على الشريحة | قليلة، وكثير منها إيجابيات كاذبة | ما تنكشف |
| الملف بعد الـ imputation | عشرات الملايين من مواقع متغيرات اللوحة، مستنتجة | موثوقة في الغالب | غير موثوقة | ما يمكن الوصول لها |
| جينوم كامل بعمق 30x | أغلب الجينوم، مقاس، مع تفويت بعض المناطق الصعبة | نعم، خارج المناطق الصعبة في الـ mapping | في الغالب | ينكشف بعضها ويفوت كثير |
Scroll the table sideways for the rest →
وش يعطيك كل نوع ملف في المتغيرات الشائعة، والمتغيرات النادرة، والتغيرات الهيكلية.
متى يكون التسلسل هو الجواب الصادق الوحيد
- تاريخ العائلة يشير لجين معين وتحتاج تعرف إذا كنت حامل متغير نادر فيه.
- نتيجة ممكن تدخل في قرار طبي. البيانات المتوقعة ما المفروض تبدأ هالنقاش، المفروض يبدأ بالتسلسل أو بفحص سريري، والمختبر السريري يأكد النتيجة في الحالتين.
- أصولك ما لها تمثيل كافي في اللوحات المرجعية والمتغيرات اللي تهمك إقليمية.
هل يستاهل؟
يستاهل لتحليلات من نوع GWAS، وللدرجات متعددة الجينات (polygenic scores) اللي تجمع آلاف التأثيرات الصغيرة، لأن كم نتيجة غلط تذوب في المجموع، ولمطابقة rsIDs تحتاجها أداة ثانية. وما يستاهل إذا اللي تبيه جواب سريري عن متغير نادر واحد. الغلطة الشائعة إنك تعامل الملف المتوقع كأنه جينوم متسلسل.
وين تروح من هنا
أداة الـ DNA المجانية على https://healthosx.com/ar/dna تقرأ ملف 23andMe أو AncestryDNA أو MyHeritage الخام، أو ملف VCF لجينوم كامل. نتائج الصفات والاستجابة للأدوية والنتائج المتعلقة بحمل الأمراض الوراثية تشتغل في متصفحك. أما تحليل الأصول الاختياري فمختلف: يشتغل على سيرفرنا، وفقط بموافقتك الصريحة، ويرسل بس الـ markers اللي يحتاجها.
الأداة ما تعطيك ملف imputation تنزّله. محادثة Ask your DNA فيها، للي يختارون يحفظون ملفهم، تكمّل ملف الشريحة بالـ imputation مقابل 1000 Genomes في حوالي 10 دقائق، وهالـ imputation يُستخدم فقط للأجوبة اللي تعطيها المحادثة. إذا تبي ملف VCF متوقع تقدر تنزّله، استخدم سيرفر Michigan أو TOPMed مثل ما شرحنا فوق.
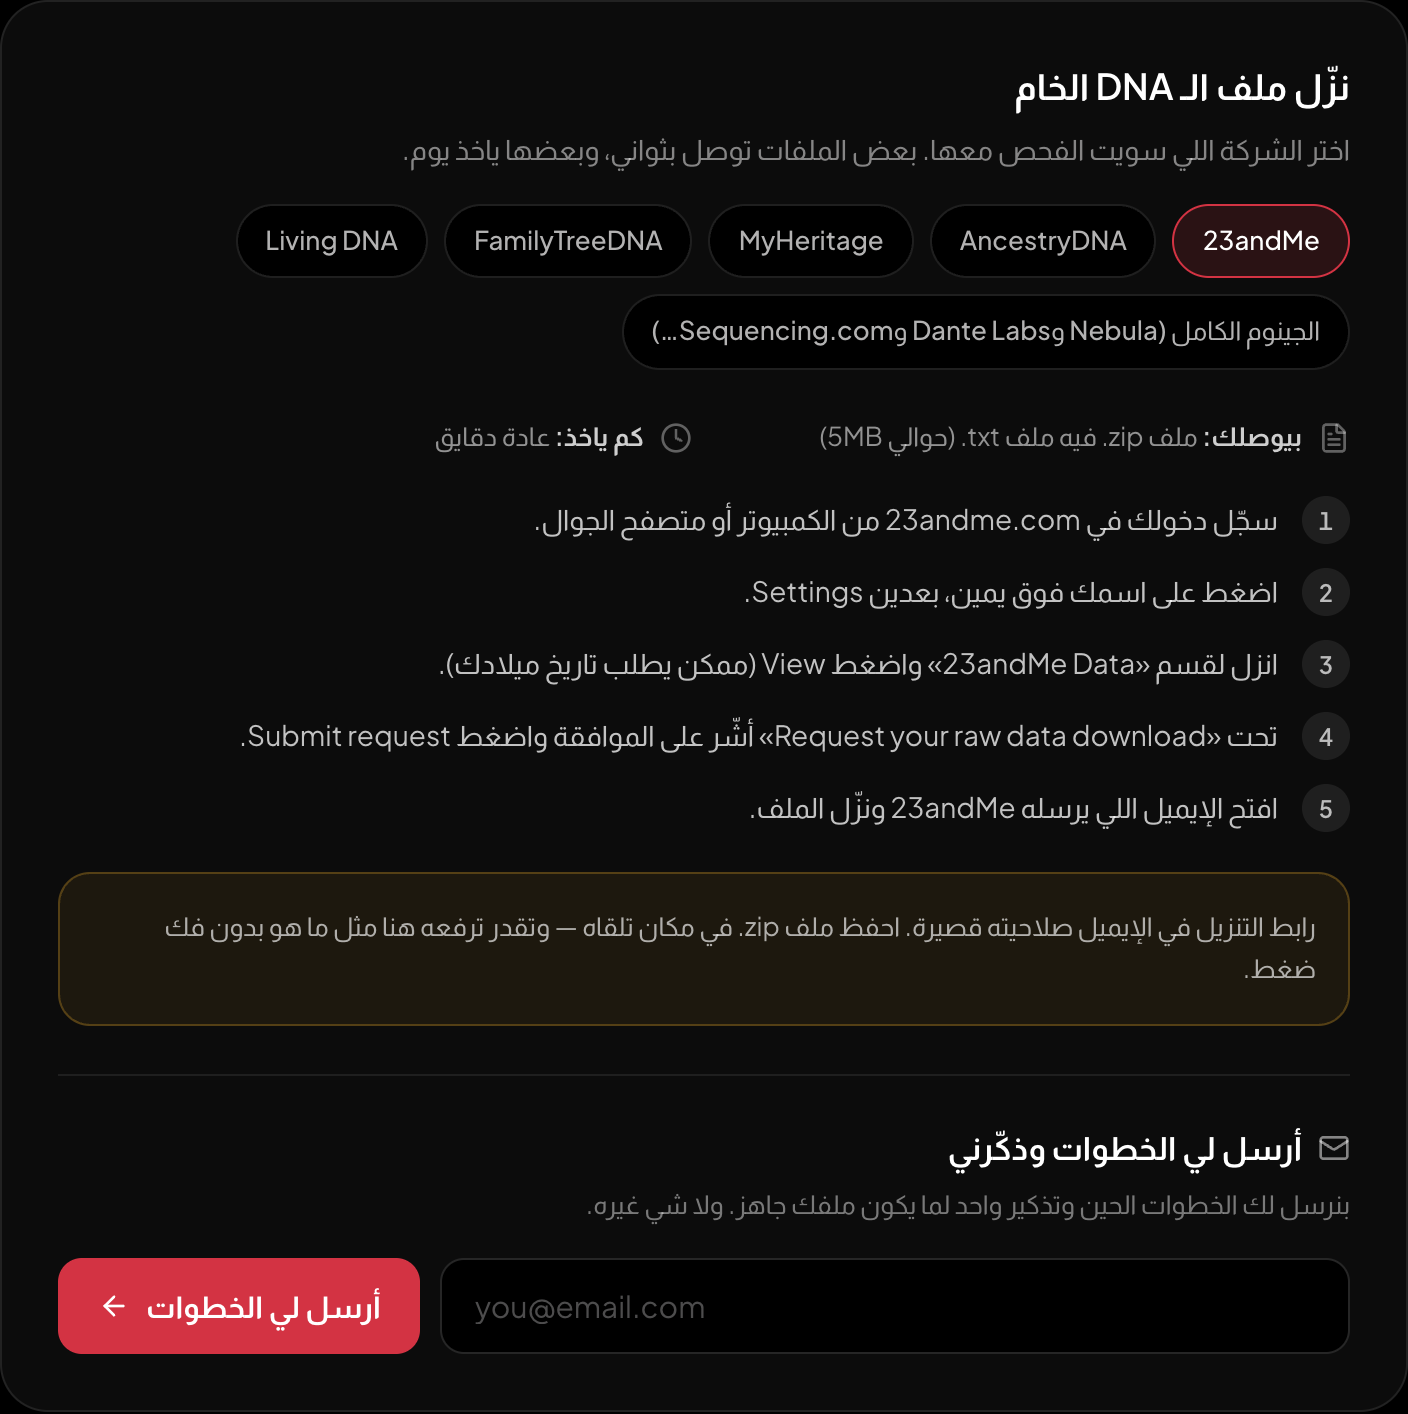
خطوات تنزيل ملف 23andMe داخل الصفحة نفسها.
الأصول مقارنة مع 1,840 جينوم مرجعي.
هاللوحة فيها 2,504 شخص وما فيها ولا مجموعة سكانية من الشرق الأوسط أو شمال أفريقيا أبدًا، فحسب المنطق اللي فوق هي أضعف من TOPMed للمتغيرات النادرة والإقليمية. نتائجها متعددة الجينات تنعرض مقارنة بهؤلاء الـ 2,504 شخص، ومو أبدًا كتوقّع. إذا نتيجة نادرة تهمك، فهذا سؤال للتسلسل الجيني.
جديد على ملفات DNA الخام؟ ابدأ بالدليل الكامل: كيف تحلل ملف 23andMe الخام مجانًا
كتابة
فريق أبحاث HealthOSX