كم عدد SNPs المفروض يكون في ملف 23andMe أو AncestryDNA الخام؟ وكيف أعرف إن ملفي ناقص؟
ملف 23andMe أو AncestryDNA الخام فيه تقريبًا من 575,000 إلى 960,000 سطر بيانات حسب الشركة ونسخة الشريحة. هنا تعرف كيف تعدّها وتكتشف الملف الناقص.
ملف البيانات الخام من 23andMe أو AncestryDNA المفروض يكون فيه تقريبًا من 575,000 إلى 960,000 سطر بيانات، مو ملايين، وهذا يعتمد على الشريحة: حوالي 575,000 لـ 23andMe v2 (تقريبًا من 2008 إلى 2010)، وحوالي 960,000 لـ v3، وحوالي 600,000 لـ v4، وحوالي 640,000 لـ v5، وحوالي 700,000 لـ AncestryDNA v1 (الملفات من قبل 2016 تقريبًا)، ومن 670,000 إلى 680,000 تقريبًا لـ AncestryDNA v2. وإذا أخذت العدد مع اسم الشركة وشكل الملف، غالبًا يدلّك على نسخة شريحتك.
ليش ملف الشريحة فيه مئات الآلاف من الأسطر مو ملايين
فحص الـ DNA التجاري مو تسلسل جيني. المختبر يستخدم مصفوفة تنميط جيني (genotyping array)، وهي شريحة عليها مجموعات من المجسّات (probes)، مجموعة لكل موقع اختارته الشركة المصنّعة مسبقًا. الـ DNA من لعابك يلتصق بالمجسّات، والجهاز يقرأ أي حرف عندك في كل واحد منها. وما يقرأ أبدًا أي شيء ما حطّه المصمّمون على الشريحة.
الجينوم البشري طوله حوالي 3 مليارات حرف، فحتى الـ 640,000 موقع تقريبًا على شريحة 23andMe v5 ما تمثّل إلا حوالي 0.02% منه.
المواقع هذي اختاروها لأنها تختلف من شخص لشخص، ومنتشرة بما يكفي عشان تعطي معلومة مفيدة. وعشان كذا العدد في الغالب صفة من صفات الشريحة، مو صفة فيك أنت. بالمقابل، التسلسل الجيني الكامل (whole-genome sequence) يسرد عدة ملايين موقع يختلف فيها الشخص عن المرجع، وملفه شكله مختلف تمامًا عن هذا.
عدد الأسطر المتوقّع حسب الشركة ونسخة الشريحة
يعتمد على الشركة وعلى نسخة الشريحة. الأرقام تحت تقريبية، لأن كل شركة عدّلت شريحتها مع الوقت، والعدد الدقيق للأسطر يختلف ببضعة آلاف من ملف لملف. دوّر على الصف اللي يطابق الشركة والسنة اللي سوّيت فيها الفحص.
| الشريحة | سنوات الاستخدام (تقريبًا) | أسطر البيانات | الحد الأدنى السليم (دليل) | الترويسة | طريقة كتابة الـ no-call | ينتهي عند |
|---|---|---|---|---|---|---|
| 23andMe v2 | 2008 إلى 2010 | حوالي 575,000 | انتبه إذا أقل من ~475,000 | أسطر # | -- | MT |
| 23andMe v3 | 2010 إلى 2013 | حوالي 960,000 | انتبه إذا أقل من ~850,000 | أسطر # | -- | MT |
| 23andMe v4 | 2013 إلى 2017 | حوالي 600,000 | انتبه إذا أقل من ~500,000 | أسطر # | -- | MT |
| 23andMe v5 | 2017 وبعدها | حوالي 640,000 | انتبه إذا أقل من ~550,000 | أسطر # | -- | MT |
| AncestryDNA v1 | قبل 2016 تقريبًا | حوالي 700,000 | انتبه إذا أقل من ~600,000 | أسطر # وسطر عناوين أعمدة واحد | 0 0 | كروموسوم 26 |
| AncestryDNA v2 | من 2016 تقريبًا وبعدها | حوالي 670,000 إلى 680,000 | انتبه إذا أقل من ~600,000 | أسطر # وسطر عناوين أعمدة واحد | 0 0 | كروموسوم 26 |
Scroll the table sideways for the rest →
أرقام تقريبية. العدد الدقيق يختلف ببضعة آلاف من ملف لملف. السنوات تقريبية، والحدود الدنيا دليل تقريبي مننا، مو حد رسمي من الشركة.
ثلاث أشياء الناس يغلطون فيها. أولًا، الرقم الأكبر ما يعني فحص أفضل. ملف v3 هو الأطول، وهو مو الأحدث. ثانيًا، AncestryDNA مو رقم واحد، ولا 23andMe كذلك. ملف AncestryDNA v2 سليم فيه 670,000 إلى 680,000 سطر مو ناقص 3 إلى 4% عن ملف v1 فيه 700,000، هو ببساطة شريحة مختلفة. وملف 23andMe v2 سليم فيه حوالي 575,000 سطر ممكن يبان ناقص جنب v4 أو v5 وهو بس شريحة أقدم. ثالثًا، مقارنة عددك بعدد صديقك ما لها معنى إلا إذا كنتوا الاثنين على نفس نسخة الشريحة. أعداد 23andMe v2 (حوالي 575,000) وv4 (حوالي 600,000) وv5 (حوالي 640,000) وAncestryDNA v2 (حوالي 670,000) قريبة من بعض نوعًا ما، فاستخدم الشركة وشكل الملف والعدد مع بعض. ملف 23andMe قديم وملف أحدث ممكن يختلفون بمئات الآلاف من الأسطر والاثنين سليمين تمامًا.
الحدود الدنيا في الجدول دليل تقريبي مننا، مو حد رسمي من الشركة.
على أي نسخة شريحة أنا؟
ترويسة ملفات AncestryDNA تذكر نسخة المصفوفة في سطر يبدأ بـ #، مثلًا AncestryDNA array version: V2.0، فافتح أول الملف واقرأها هناك. ترويسة 23andMe ما تذكر الشريحة، فلملف 23andMe الدليل هو عدد الأسطر وتاريخ الفحص: حوالي 575,000 سطر وفحص تقريبًا بين 2008 و2010 يدل على v2، وحوالي 960,000 وبين 2010 و2013 على v3، وحوالي 600,000 وبين 2013 و2017 على v4، وحوالي 640,000 و2017 أو بعدها على v5. ولأن أعداد v2 وv4 وv5 قريبة، تاريخ الفحص هو اللي يحسم أغلب الشيء هناك.
عدّ الأسطر بنفسك
إذا الملف .zip فكّ الضغط أول. بعدين عدّ أسطر البيانات بس، بدون الترويسة.
- 23andMe: الأمر
grep -vc '^#' genome.txtيطبع عدد أسطر البيانات. سطر عناوين الأعمدة هنا يبدأ بعلامة #، فهو أصلًا مستبعد. - AncestryDNA: نفس الأمر يعدّ سطر زيادة، لأن سطر عناوين الأعمدة (
rsid chromosome position allele1 allele2) ما فيه علامة #. اطرح واحد. - بدون فك الضغط:
unzip -p yourfile.zip | grep -vc '^#'. - على Windows بدون terminal، أي محرر نصوص يعرض أرقام الأسطر يمشي الحال، بس لا تفتحه في Excel وتحفظه من جديد. هذا ممكن يعيد كتابة الملف.
- للتأكد، قارن مع
wc -l yourfile.txt، اللي يعدّ كل الأسطر بما فيها الترويسة، فالمفروض يطلع أكبر بعدد أسطر الترويسة. نهايات الأسطر حق Windows (CRLF) ما تغيّر أي واحد من العددين.
بعدها شوف آخر الملف بـ tail -n 3 yourfile.txt. آخر الأسطر المفروض تكون على كروموسوم الميتوكوندريا، مكتوب MT في ملف 23andMe أو 26 في ملف AncestryDNA، والسطر الأخير لازم يكون كامل. إذا مو كامل، شوف قسم الملف التالف تحت.
أسطر الترويسة والـ no-calls تأثيرها على المجموع أقل مما تتوقع
أول الملف مجموعة أسطر تبدأ بـ #. في ملفات 23andMe هي ملاحظة قصيرة عن البيانات ونسخة الجينوم المرجعي (reference genome build). وملفات AncestryDNA فيها ملاحظة مشابهة. هذي عشرات قليلة من الأسطر بالكثير، فما تفسّر أبدًا فرق كبير. تفسّر بس إنك طالع بفرق كم سطر.
والـ no-calls تأثيرها على العدد أقل حتى، لأنها تبقى في الملف كأسطر. الـ no-call موقع ما قدرت الشريحة تعطي فيه قراءة موثوقة. 23andMe تكتبه -- في عمود النمط الجيني (genotype)، وAncestryDNA تكتبه 0 0 في عمودي الأليلات. عدّها بـ grep -c -e '--$' genome.txt، أو لـ Ancestry بـ awk '!/^#/ && $4==0 && $5==0' file.txt | wc -l. إذا الملف فيه نهايات أسطر Windows (CRLF)، كل سطر ينتهي بـ carriage return، فالنمط '--$' ما يطابق ولا شيء ويطلع لك صفر. احذفها أول، مثلًا tr -d '\r' < genome.txt | grep -c -e '--$'، وسوّ نفس الشيء قبل أمر awk.
أغلب الملفات السليمة فيها نسبة صغيرة بس من الـ no-calls، والنسبة الدقيقة تختلف حسب الشريحة والعيّنة. ما فيه حد رسمي للعيّنة الضعيفة. كدليل تقريبي مننا، مو حد من الشركة: نسبة فوق حوالي 5 إلى 10% تدل على عيّنة ضعيفة أكثر من ملف ناقص، ويستاهل تسأل الشركة عن إعادة الفحص.
الكروموسومات الجنسية لها ملاحظة خاصة. عند الرجال، 23andMe ممكن تكتب قراءات X وY بشكل مختلف، كحرف واحد أو كـ --، فالرجل لا يعتبر الـ no-calls في Y تلف. عند النساء، أسطر Y كلها تقريبًا no-calls، وهذا طبيعي.
وفيه بعد فروقات في طريقة كتابة الأسطر. 23andMe تستخدم X وY وMT للكروموسومات الجنسية والميتوكوندريا. AncestryDNA تستخدم أرقام: 23 لـ X، و24 لـ Y، و25 للمنطقة شبه الجسمية (pseudoautosomal region)، و26 لـ DNA الميتوكوندريا. بعض الأسطر في ملف 23andMe معرّفاتها تبدأ بـ i بدل rs. هذي معرّفات داخلية، مو أخطاء.
متى يكون الملف القصير ملف تالف
الملفات هذي مرتّبة حسب الكروموسوم وبعدين حسب الموقع. وهذا مفيد، لأن التحميل المقطوع يضيّع النهاية، والنهاية تقدر تتعرّف عليها.
- السطر الأخير المفروض يكون موقع ميتوكوندريا (MT في 23andMe، و26 في AncestryDNA)، وهذا اللي المفروض يطلّعه لك
tail -n 3. إذا انتهى عند كروموسوم 9، أو وقف في نص سطر، فالملف انقطع. - عدد أقل بوضوح من الحد الأدنى السليم لنسخة شريحتك في الجدول يدل على نفس الشيء، لأن العدد القصير غالبًا معناه ملف تالف.
- ملف zip ما ينفتح، أو ينفتح على ملف نصي حجمه صفر بايت أو صغير جدًا، معناه إن التحميل ما كمل. حمّله من جديد من حسابك بدل ما تحاول تصلحه.
- الملف اللي انفتح وانحفظ من جديد في برنامج جداول أو معالج نصوص ممكن تنضاف له علامات تنصيص، أو تتغيّر الفواصل فيه، أو يضيع الفصل بالـ tab. عدد الأسطر ممكن يبان طبيعي والبرامج ترفض تقرأه.
غياب قسم MT أو Y يفرق عمليًا، لأن السلالة من جهة الأم تنقرأ من MT والسلالة من جهة الأب من Y (عند النساء أسطر Y متوقع تكون فاضية، والسلالة من جهة الأب ما تنطبق). كروموسوم X ما يُستخدم للمجموعات الفردانية (haplogroups)، بس غياب قسم X يفرق لأسباب ثانية، مثل التحقق من الجنس وبعض الصفات.
فيه SNP كنت أبيه ومو موجود في ملفي. هل ضاع شيء؟
غالبًا لا. إذا الموقع ما كان أصلًا على شريحتك، ما راح يكون له سطر، مهما كان الـ SNP مشهور. هذي أكثر مفاجأة شائعة: واحد يدوّر على rsID معيّن من بحث علمي، ما يلقى شيء، ويفترض إن الملف ناقص. نسخ الشرائح تختلف في المواقع اللي تشملها، فممكن variant يكون موجود في ملف v4 ومو موجود في v5، أو العكس. ولا شركة تعطيك موقع ما قاسته.
ملف الشريحة يسرد المواقع اللي انبنت الشريحة عشان تقراها، مو جينومك كامل، فشيّك على السطر الأخير ونسخة الشريحة قبل ما تقرر إن فيه شيء ناقص.
وإذا السطر موجود ومكتوب فيه no-call، فهذي حالة ثانية: الموقع انقاس وفشل، وإعادة رفع الملف ما راح تصلحه.
افحص ملفك قبل ما تعتمد عليه
عشان تعرف إذا ملفك راح يشتغل، استخدم فحص الملفات المجاني في HealthOSX، المبني بالضبط لهذا السؤال. إنك تتأكد إن طول الملف طبيعي هو أول شيء يستاهل تتأكد منه قبل ما تقرأ أي نتيجة، لأن التقرير ما يغطي إلا المواقع اللي شريحتك فعلًا قاستها.
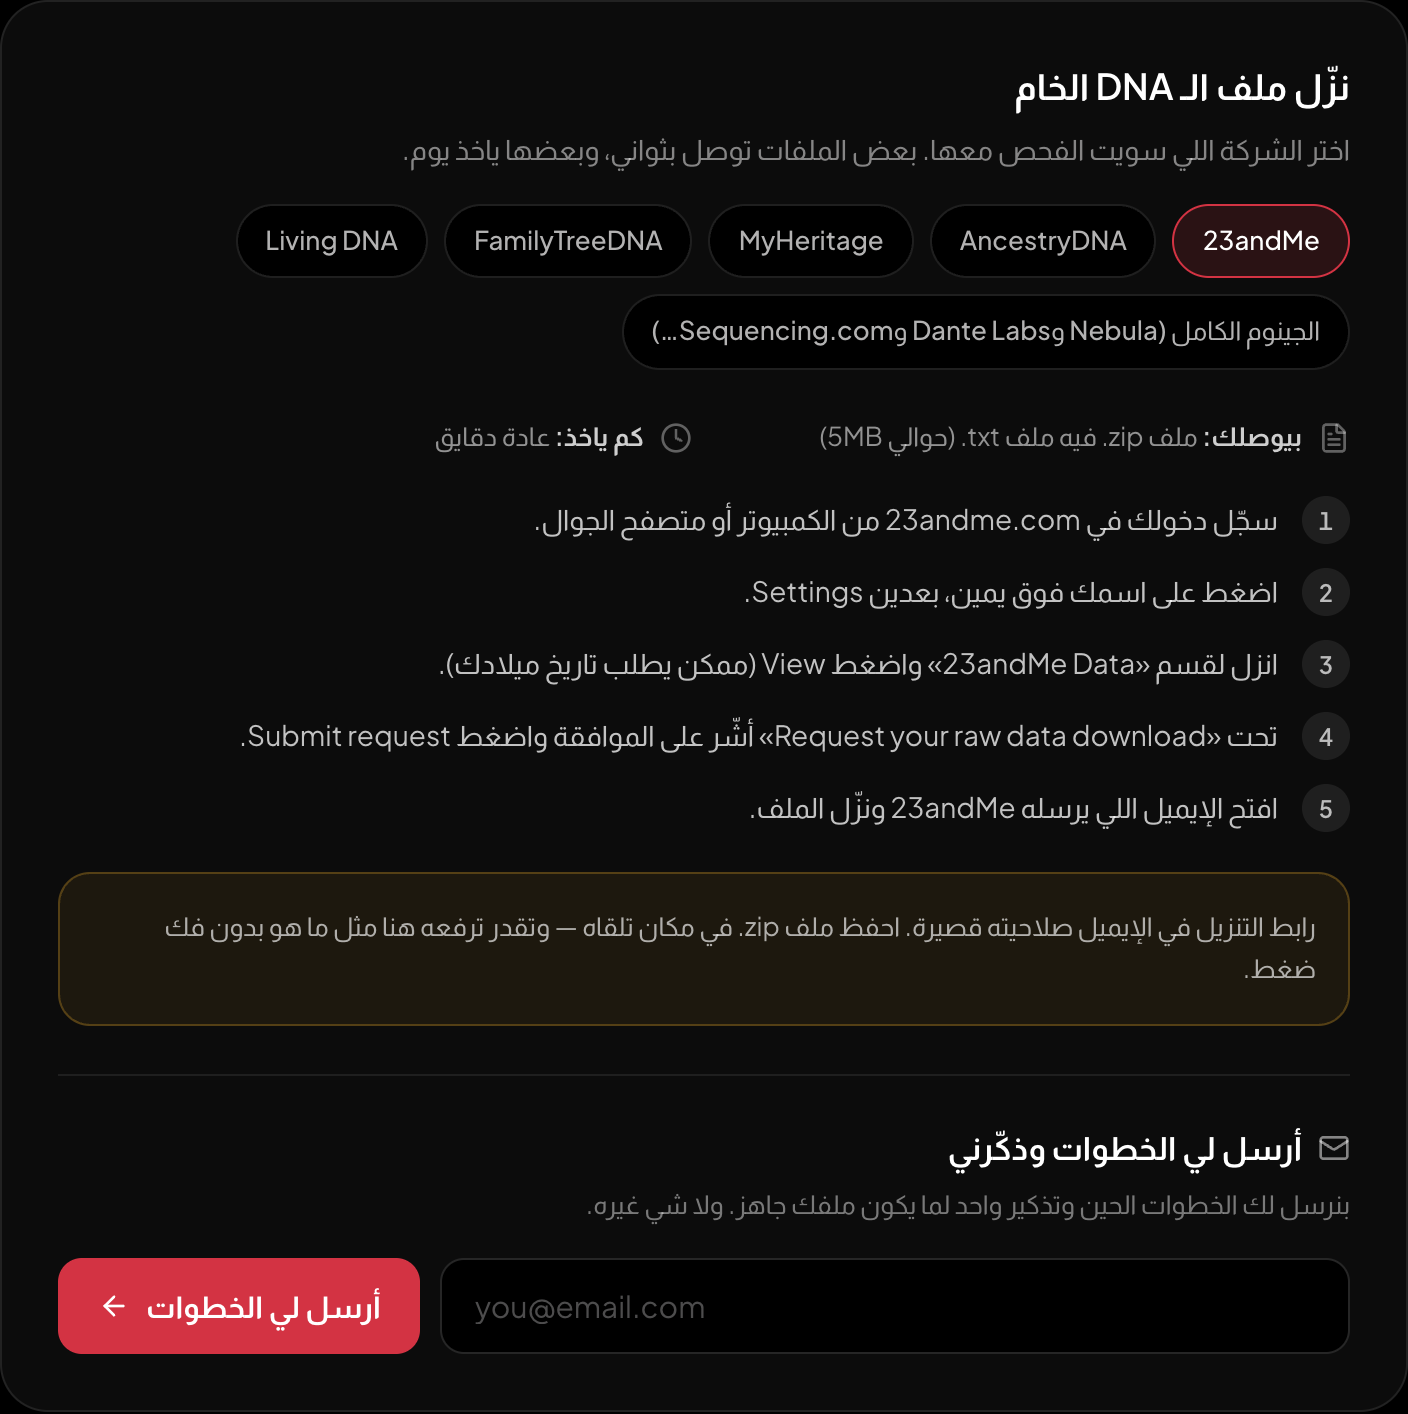
خطوات تنزيل ملف 23andMe داخل الصفحة نفسها.
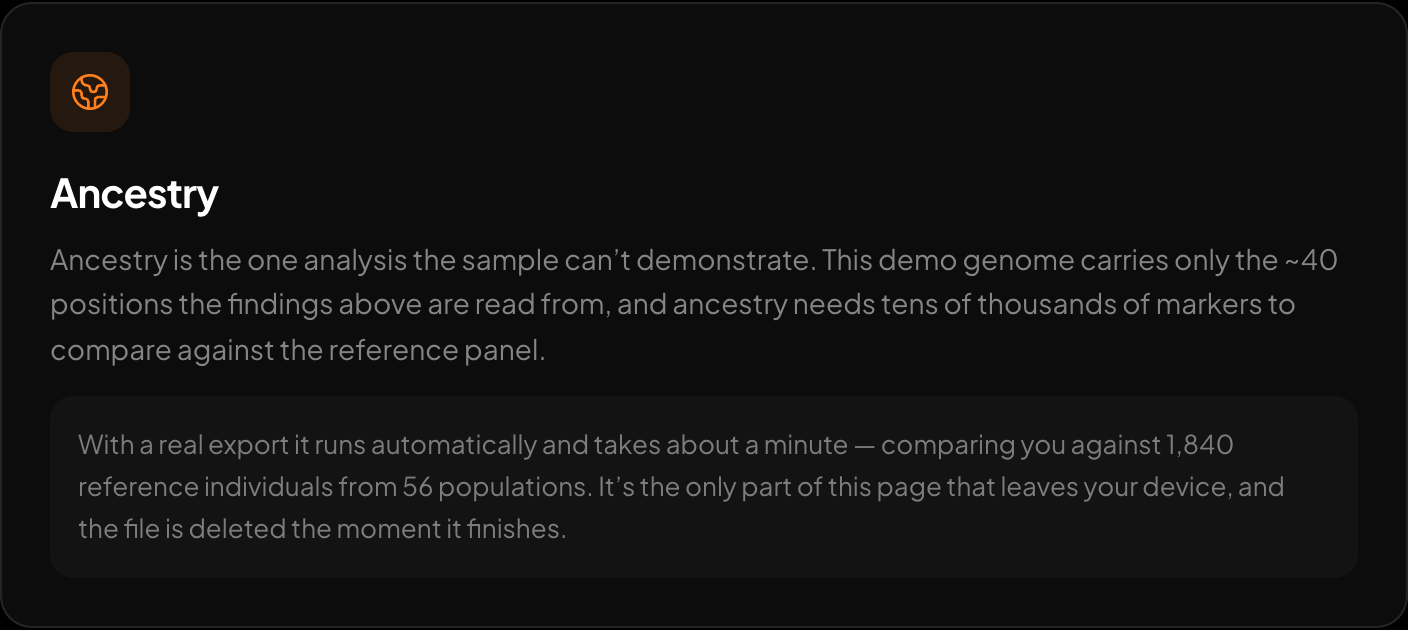
الأصول مقارنة مع 1,840 جينوم مرجعي.
لما يطلع الملف سليم، أداة الـ DNA في HealthOSX تقرأ ملف خام من 23andMe أو AncestryDNA أو MyHeritage وتعرض الصفات، والاستجابة للأدوية، وحالة الحمل الوراثي (carrier status)، والنتائج الصحية من متغيّر واحد (single-variant). وتقرأ بعد السلالة من جهة الأم والأب (mtDNA وY haplogroups)، وكل التحليل يصير في المتصفح على جهازك.
جديد على ملفات DNA الخام؟ ابدأ بالدليل الكامل: كيف تحلل ملف 23andMe الخام مجانًا
كتابة
فريق أبحاث HealthOSX